 A
Développer avec des agents IA : la méthode d'un ingénieur, le cas ReCoDanse
Je construis seul une application complète, avec des agents IA qui travaillent en parallèle. Voici la méthode : un plan découpé en lots, des sessions qui s'écrivent au lieu de se parler, une forge et un lab auto-hébergés, des tests faits pour se méfier des tests, une démo chaque soir et une recette à la main. Le cas d'étude : ReCoDanse.
Je suis ingénieur logiciel. Depuis juillet 2026, je construis une application complète — une application web, une API et une application iPhone — sans équipe. Je ne suis pourtant pas seul à écrire le code : des agents IA travaillent en parallèle, et mon rôle est surtout de décider, d'arbitrer et de vérifier.
Cet article décrit la méthode. L'application qui me sert de terrain s'appelle ReCoDanse : elle aide les danseurs à s'entraîner à partir des vidéos de leurs cours. Elle a son propre article, qui dit ce qu'elle fait et pourquoi : ReCoDanse, l'application pour s'entraîner à danser.
Le cas, en chiffres
Relevés le 28 octobre 2026, dans les dépôts du projet :
| Premier commit de l'application web | 12 juillet 2026 |
| Applications | web (Nuxt, Vue), API (Go), iPhone (Swift) |
| Lots au plan | 171 |
| Trains de fusion passés | 46 |
| Versions numérotées | de v0.1.0 (24 octobre) à v0.23.0 (28 octobre) |
| Scénarios Gherkin joués (niveau domaine) | plus de 4 000 |
| Tests unitaires | plus de 11 000 |
Ces chiffres ne mesurent pas la qualité. Ils disent l'échelle : à ce rythme, on ne relit pas tout. La méthode sert à savoir quoi vérifier, et à rendre le reste vérifiable sans moi.
Un plan découpé en lots
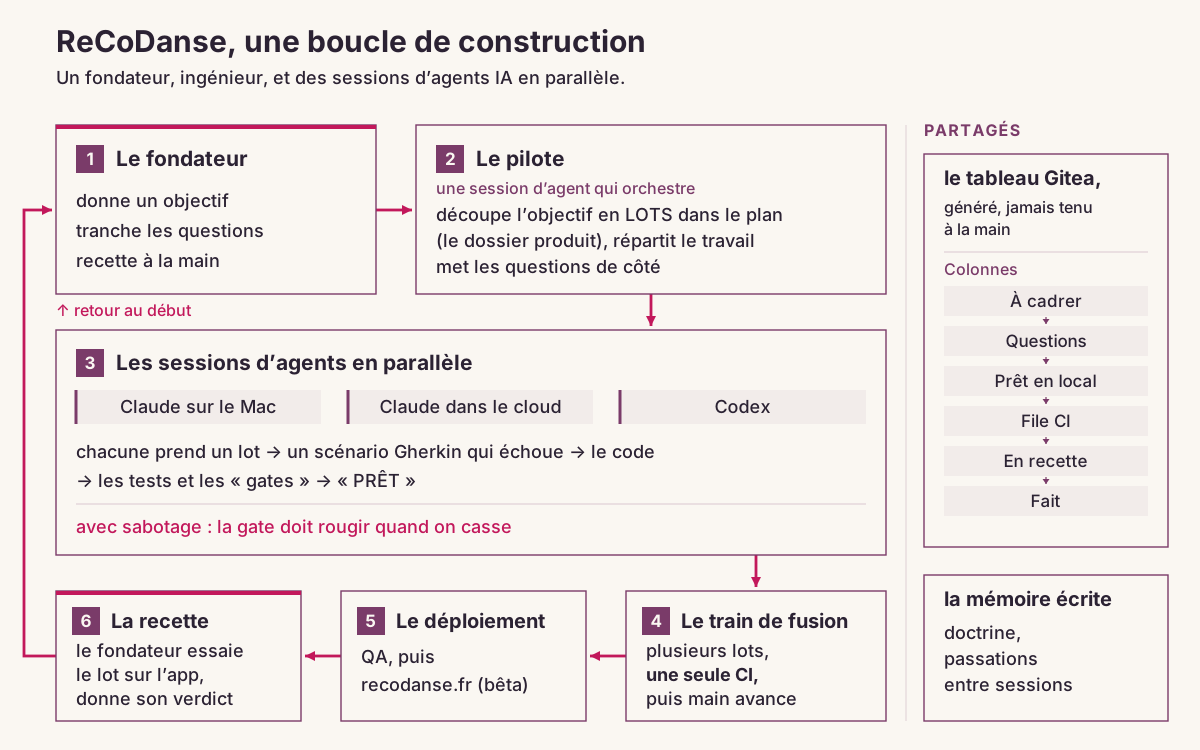
Le produit est décrit dans un dépôt à part, le « dossier » : une fiche par fonctionnalité, un glossaire, des décisions datées. Le travail y est découpé en lots de recette. Un lot est une chose que je peux essayer moi-même sur l'application et accepter ou refuser. Ce n'est pas une tâche technique.
Chaque lot suit le même chemin :
- un scénario Gherkin en français, qui échoue tant que la fonctionnalité n'existe pas ;
- le code, côté application web, API et iPhone si le lot les touche ;
- les tests et les « gates », des contrôles automatiques, chacun saboté une fois pour prouver qu'il sait échouer ;
- une fusion en train avec d'autres lots prêts ;
- le déploiement, d'abord en QA, puis en production ;
- la recette : j'essaie le lot sur mon téléphone et je donne mon verdict.
Un lot n'est jamais « livré » parce que l'intégration continue est verte. Entre la fusion et mon verdict, il est « en recette », c'est-à-dire pas prêt.
Des agents en parallèle
Chaque lot est confié à une session d'agent IA (Claude Code sur mon Mac ou dans le cloud, parfois Codex). Une session est « pilote » : elle découpe, répartit le travail entre les autres, surveille la file de l'intégration continue et met les questions de côté. Je les reçois par lot, souvent le matin, au lieu d'être interrompu toutes les dix minutes.
Les sessions ne partagent pas de conversation. Elles partagent des écrits :
- une doctrine : les règles du dépôt, chacune avec l'histoire qui l'a fait naître. Une règle se lit en une ligne ; son récit explique pourquoi on ne la contredit pas à la légère ;
- des fiches de passation, pour qu'une session reprenne le travail d'une autre ;
- une file commune : les sessions y écrivent avant de lancer un gros calcul, et un « gel » y suspend tout le monde pendant qu'un train passe. Toutes tournent sur la même machine.
Une forge et un lab chez moi
Gitea, sur des Raspberry Pi
Le code vit sur une forge Gitea auto-hébergée, dans mon home lab : trois Raspberry Pi en cluster k3s. Je l'ai décrit en détail dans Home lab — usine logicielle. Les tâches d'intégration continue tournent sur des runners Gitea Actions, sur les Raspberry Pi et sur le Mac.
Chaque fusion sur la branche principale construit une image ; ArgoCD la déploie sur le cluster du lab, sur un environnement interne. La QA et la production tournent sur une machine virtuelle louée en France, installée par Ansible : le même playbook la reconstruit de zéro, et une restauration de la base a été chronométrée sur des machines jetables (moins de 20 secondes pour une base vide).
Un tableau généré, jamais tenu à la main
Le suivi du projet est un tableau de cette forge, avec une carte par lot et six colonnes : À cadrer, Questions au fondateur, Prêt en local, Dans la file CI, En recette, Fait.
Personne ne déplace les cartes. Un script relit les sources (le plan, les branches, les demandes de fusion, la file de la CI, les questions ouvertes) et place chaque carte dans la colonne que ces sources prouvent. Si une carte est mal placée, c'est une source qui est fausse : on corrige la source, pas la carte.
Le tableau « Bêta » le 28 octobre 2026, avant et après une passe du script :
Les secrets : Vault, l'OIDC de Gitea, et rien à la main
Dans le lab, les secrets vivent dans HashiCorp Vault. Une tâche de CI ne porte aucun mot de passe : elle demande à Gitea un jeton OIDC de courte durée, et Vault l'échange contre des droits limités à cette application. Le mécanisme est détaillé dans l'article sur le home lab.
Pour ReCoDanse, une règle s'y ajoute : tout ce qui vit dans Vault est déclaré en code, jamais écrit à la main. Un agent qui a besoin d'un nouveau secret écrit son chemin dans l'IaC ; la valeur est générée ou fournie au moment de l'application. Un agent n'a donc jamais besoin de lire un secret pour en déclarer un. Et aucun identifiant sensible n'est embarqué dans l'application, même pour les tests. En production, les secrets sont chiffrés dans le dépôt d'infrastructure (SOPS).
L'infrastructure comme code
OpenTofu (le fork libre de Terraform) décrit ce qui vit hors du cluster : le DNS et le pare-feu Cloudflare, les seaux de stockage des vidéos, les entrées de Vault. C'est du déclaratif : on écrit l'état voulu, l'outil calcule l'écart et l'applique.
C'est ce qui rend l'infrastructure confiable à des agents. Un changement est un diff, relu comme du code, rejouable, et qu'on peut annuler. Une modification faite à la main dans une console, elle, ne laisse rien à relire.
Des tests faits pour se méfier des tests
Quand un agent écrit à la fois le code et ses tests, le risque n'est pas qu'il oublie de tester. C'est qu'un test passe pour une mauvaise raison. Toute la stratégie part de là.
Trois niveaux de preuve
- N1, le domaine : les règles métier, écrites en Gherkin français et jouées en Node, sans navigateur ;
- N2, l'écran : les scénarios marqués
@ecrandes mêmes fichiers, joués par Playwright contre Storybook, la documentation vivante des composants ; - N3, la main : moi, sur l'application déployée.
Un scénario réel, tiré du lot « Commencer un programme » :
Scénario: Toucher une carte change ce que « Commencer » lance
  Étant donné mon programme « Rock » sur les passages "r1, r2", 1 par jour, défini le 2026-10-01
  Et mon programme « Mambo » sur les passages "m1, m2", 1 par jour, défini le 2026-10-02
  Quand je touche la carte « Rock »
  Alors « Commencer » lance « Rock », jour 1 sur 2
Le scénario est écrit avant le code, dans les mots de l'écran. Il échoue d'abord ; il passe ensuite. Je peux le lire sans ouvrir le code.
Les gates
Les « gates » sont des contrôles Playwright joués sur une construction de production, jamais en mode développement. Ils mesurent ce qu'un humain remarquerait trop tard : le contraste des couleurs, une taille de texte d'au moins 16 px, des cibles tactiles d'au moins 48 px, l'espace entre deux boutons voisins, le temps de chargement de l'accueil sur une connexion 4G simulée, l'étanchéité entre les modules du code. Les plus sensibles se jouent sur trois moteurs : Chromium, Firefox et WebKit.
Le sabotage
Chaque gate arrive avec son sabotage : on casse exprès ce qu'elle garde, on vérifie qu'elle échoue, on rétablit, on vérifie qu'elle repasse, et on note les codes de sortie. La règle du dépôt le dit ainsi : un contrôle incapable d'échouer est pire qu'un contrôle absent, parce qu'il rassure.
Le projet l'a payé plusieurs fois. Une expression régulière ne trouvait jamais rien : la gate était verte sur tout, même sur un écran cassé exprès. Un test se sautait lui-même sur les demandes de fusion et ne jouait que sur la branche principale : vert sur la demande, rouge après la fusion. Chaque fois, le récit est écrit dans la doctrine, et la règle qui en sort empêche la récidive.
Lots et trains
Faire passer chaque lot seul dans l'intégration complète coûtait près d'une heure par lot. Les lots prêts passent donc ensemble, en train : une branche qui les réunit, une seule intégration complète, et la branche principale avance exactement sur le commit testé. Si le train est rouge, on cherche le wagon fautif par bissection, on le retire, et le reste repart. On ne corrige jamais dans le train.
Par défaut, une demande de fusion ne joue qu'un socle de contrôles, en quelques minutes. Le reste se demande explicitement, par une ligne dans le message du commit (« CI: storybook », « CI: tout »). Et tout se rejoue chaque nuit sur la branche principale : un défaut qu'on n'a pas demandé à voir est vu le lendemain matin, et la branche est gelée jusqu'à sa correction.
Le numéro de version, enfin, ne naît qu'après le verdict vert de la branche principale.
Les visites de recette
Quand un lot m'est rendu, un agent écrit sa visite : les étapes à faire, les scénarios Gherkin à constater. Playwright la joue sur l'application déployée, avec un compte de test, et la filme. La page de la visite, ses captures et son verdict sont rangés dans le dossier du produit. Je regarde la visite, puis je refais le parcours sur mon téléphone.
Une « cohorte » de personas fictifs rejoue aussi ses parcours après chaque lot qui touche un écran, et dit ce qui a bougé : une friction disparue, une friction revenue.
Une démo de sprint, chaque soir
Une vingtaine de sessions peuvent travailler en même temps. Je ne peux pas lire chaque demande de fusion. Le soir, une session prépare donc une démo de sprint, comme en Scrum : une vidéo commentée, avec chapitres et sous-titres, qui montre ce qui est arrivé dans la journée.
Elle est construite en mettant à jour le vrai tableau à partir de ses sources, pas en l'habillant : si une carte n'avance pas, la démo le montre. Elle m'est envoyée et s'ouvre dans le navigateur, pour que je la regarde en rentrant. C'est souvent elle qui fait naître les questions du lendemain.
La même application, en web et sur iPhone
La version web fait référence. L'application iPhone native doit offrir les mêmes choses, aux mêmes endroits, aussi facilement. Pour le vérifier, une même visite est jouée automatiquement des deux côtés, sur un compte de démonstration : à gauche l'app native dans le simulateur iPhone, à droite la PWA dans un navigateur qui imite le même iPhone.
Les petites différences de présentation propres à iOS sont voulues. Une fonction présente d'un seul côté devient une tâche.
Ce que je garde pour moi
Les agents écrivent l'essentiel du code, des tests et de la documentation. Je garde trois choses :
- décider ce que l'on construit, et dans quel ordre ;
- arbitrer le design : chaque écran se choisit sur une planche de variantes avant d'être codé ;
- recetter : rien n'est « fini » tant que je ne l'ai pas essayé à la main.
Le goulot, aujourd'hui, c'est la troisième. Au 28 octobre, sur les 171 lots du plan, 95 sont livrés et attendent ma recette. Les agents produisent plus vite qu'un humain ne vérifie. Les visites filmées et les démos du soir servent d'abord à ça : rendre ma vérification plus courte, sans la supprimer.
La suite
Deux articles suivront :
- les applications tierces : ReCoDanse ouvre une porte aux applications des autres. Une personne autorise une application à lire ses vidéos, et peut la retirer quand elle veut. La documentation pour les développeurs, dev.recodanse.fr, est en ligne : elle est générée directement depuis le contrat de l'API ;
- les chiffres du projet dans la durée : ce qui marche, ce qui ne marche pas encore, et les limites de cette façon de travailler.
En attendant, l'application est ouverte : recodanse.fr.